LM Studio
Desktop-Programm für offene Sprachmodelle auf dem eigenen Rechner — inzwischen mit eigenem Agenten („Bionic"), lokaler Spracherkennung und optionaler Cloud. Im Grundbetrieb verlässt kein Byte das Gerät.
Funktionen von LM Studio
- Lokaler Modellbetrieb: offene Modelle direkt in der App suchen, herunterladen und ausführen — mit llama.cpp und MLX als Laufzeitumgebungen.
- Bionic: der eingebaute Agent für Dokumente, Programmierarbeit, Automatisierungen und Rechnersteuerung.
- Sprachtranskription in Echtzeit, die laut Anbieter lokal verarbeitet wird und das Gerät nicht verlässt; mehrere Sprachen.
- Lokaler API-Server: stellt die laufenden Modelle im Netzwerk bereit, kompatibel zu gängigen Client-Bibliotheken.
- LM Link zur Nutzung über mehrere Geräte hinweg (im kostenlosen Tarif bis zu fünf).
- Optionale Cloud-Modelle als Zusatzstufe — US-gehostet, nach Anbieterangabe mit Zero Data Retention.
- Windows, macOS und Linux; dazu ein serverloser Kopflos-Betrieb für Hintergrunddienste.
Preise von LM Studio
- Free — 0 $: lokaler Betrieb ohne Begrenzung, auch kommerziell nutzbar. Enthält den Bionic-Agenten, llama.cpp und MLX, die Offline-Transkription, LM Link für bis zu fünf Geräte und eine eingeschränkte Websuche.
- Bionic+ — 20 $/Monat: zusätzlich US-gehostete offene Modelle (genannt werden unter anderem Kimi K3, GLM 5.3 und DeepSeek V4 Flash), Websuche mit Seitenauswertung und vergünstigte Token-Pakete.
- Pro — 100 $/Monat: fünffache Nutzungsgrenzen, weitere Token-Rabatte, früher Zugang zu neuen Funktionen.
- Für Teams gibt es eine Organisationsverwaltung mit zentraler Abrechnung.
- Wichtig: Der kostenlose, rein lokale Betrieb ist kein Lockangebot, sondern der eigentliche Kern des Produkts.
LM Studio ist der bequemste Weg, ein Sprachmodell auf dem eigenen Rechner laufen zu lassen. Wo Ollama von der Kommandozeile her kommt und sich an Entwicklerinnen richtet, ist LM Studio ein Desktop-Programm mit Oberfläche: Modelle suchen, herunterladen, laden, chatten — ohne eine Zeile Terminal.
Für dieses Verzeichnis ist das Programm aus einem Grund besonders interessant: Im Grundbetrieb findet keine Verarbeitung bei einem Anbieter statt. Das Modell liegt auf der Festplatte, die Berechnung läuft auf dem eigenen Prozessor oder der eigenen Grafikkarte, der Chatverlauf bleibt lokal. Das ist kein Datenschutzversprechen, dem man vertrauen muss, sondern eine Eigenschaft der Betriebsart — es gibt schlicht keine Verbindung, über die Inhalte abfließen könnten.
Unter der Haube arbeiten zwei Laufzeitumgebungen. llama.cpp deckt breite Hardware ab, von älteren Prozessoren bis zu NVIDIA- und AMD-Karten. MLX ist Apples Rahmenwerk für die eigenen Chips und holt aus einem Mac mit M-Prozessor deutlich mehr heraus als eine allgemeine Lösung. Wer sich nicht für solche Details interessiert, merkt davon nichts — die App wählt passend aus.
Technisch wertvoll, aber leicht zu übersehen, ist der eingebaute lokale API-Server. Er stellt die geladenen Modelle unter einer Adresse im eigenen Netz bereit, und zwar in einem Format, das zu den verbreiteten Client-Bibliotheken passt. Für Entwicklerinnen heißt das: Eine bestehende Anwendung lässt sich oft durch das Ändern einer einzigen Adresse von einem kommerziellen Dienst auf ein lokales Modell umstellen. Für Prototypen, für Arbeit mit Testdaten, die nicht nach außen dürfen, und für Umgebungen ohne Internet ist das ausgesprochen praktisch.
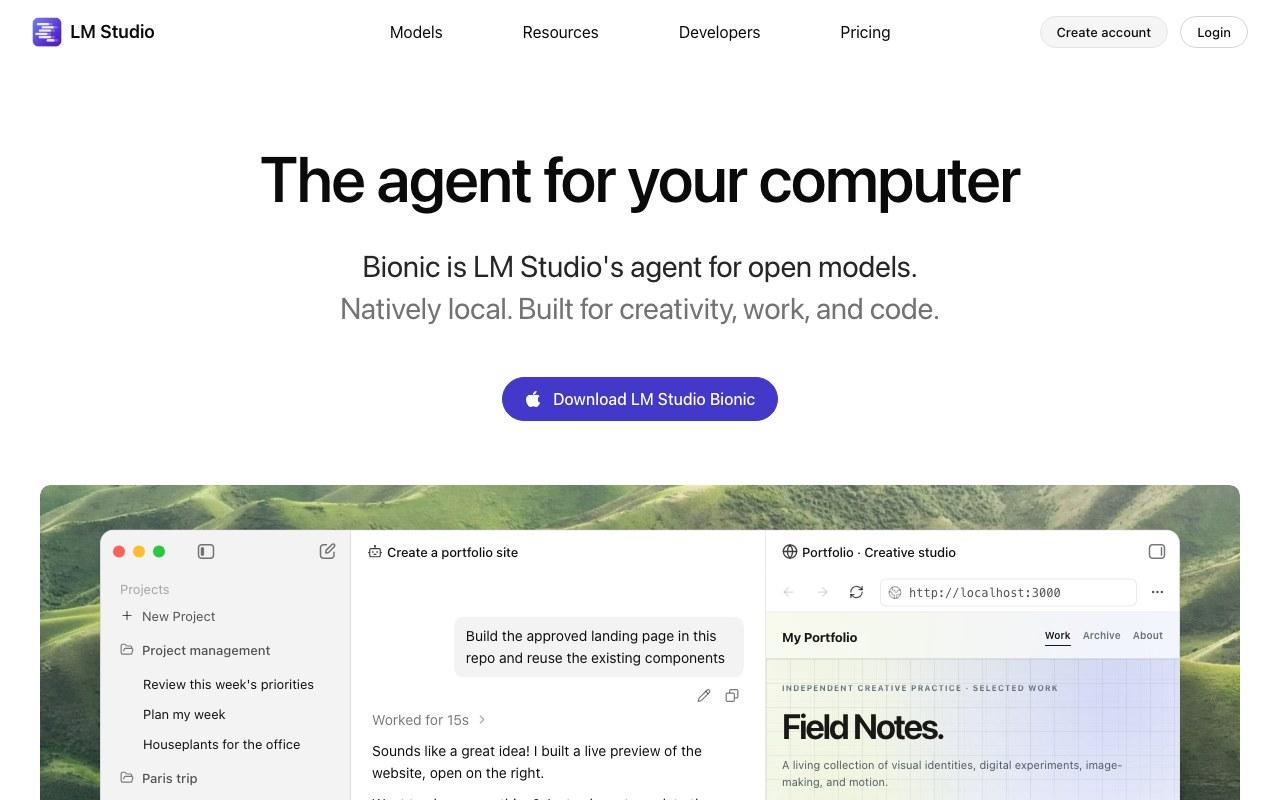
In der aktuellen Generation hat sich das Produkt deutlich erweitert. Es tritt jetzt unter dem Namen Bionic als Agent auf: Er bearbeitet Dokumente, hilft bei Programmieraufgaben, übernimmt Automatisierungen und kann den Rechner steuern. Dazu kommt eine Sprachtranskription in Echtzeit, die nach Anbieterangabe ebenfalls lokal arbeitet — Stimme und Audiodaten verlassen das Gerät nicht. Für Diktate, Gesprächsnotizen und Besprechungen ist das eine naheliegende und datenschutzfreundliche Anwendung.
Neu ist auch eine optionale Cloud-Stufe, und hier lohnt das genaue Hinsehen. Wer mehr Leistung braucht, als die eigene Hardware hergibt, kann große offene Modelle auf gehosteten Servern nutzen. Der Anbieter beschreibt diese Server als in den USA gehostet und sichert Zero Data Retention zu — Eingaben und Antworten werden nicht gespeichert. Das ist eine ordentliche Zusage, ändert aber den Charakter der Nutzung: Aus „nichts verlässt den Rechner" wird „Inhalte gehen an einen US-Dienstleister, der sie nicht aufbewahrt". Wer LM Studio wegen der Datenhoheit einsetzt, sollte die Cloud-Stufe bewusst meiden oder bewusst wählen — beides ist vertretbar, nur nicht versehentlich.
Deshalb steht der Eintrag auf DSGVO „ja", mit derselben Begründung wie bei Ollama und anderen lokalen Werkzeugen: Der Standardweg verarbeitet überhaupt nichts beim Anbieter, der Drittlandanteil ist eine ausdrücklich zuschaltbare Zusatzfunktion. Dass LM Studio ein US-Unternehmen ist, spielt für den lokalen Betrieb keine Rolle, weil dabei keine personenbezogenen Daten zum Anbieter gelangen.
Die Grenzen sollte man kennen. Hardware ist der Flaschenhals. Ein kleines Modell läuft auf fast allem; ein großes, qualitativ überzeugendes Modell will viel Arbeitsspeicher und möglichst eine ordentliche Grafikkarte oder Apple Silicon. Auf einem gewöhnlichen Bürorechner wird die Erfahrung zäh. Und bei aller Freude über offene Modelle: In der Qualität liegen sie bei anspruchsvollen Aufgaben weiterhin hinter den großen kommerziellen Modellen, auch wenn der Abstand kleiner geworden ist. Unser Artikel Lokale vs. Cloud-Modelle geht auf diese Abwägung im Detail ein.
Ein Punkt, der in Empfehlungslisten oft untergeht: LM Studio selbst ist nicht quelloffen. Die Modelle, die es ausführt, sind es — das Programm ist kostenlos, aber proprietär. Wer vollständige Quelloffenheit bis in die Oberfläche braucht, ist mit anderen Lösungen besser bedient. Für alle anderen ist das selten ein Hindernis, weil die ausschlaggebende Eigenschaft — dass nichts das Gerät verlässt — vom Modell und der Betriebsart abhängt, nicht von der Lizenz der Oberfläche.
Die Oberfläche gibt es nur auf Englisch. Die Bedienung ist allerdings weitgehend selbsterklärend, und die Modelle selbst beherrschen Deutsch je nach Wahl mehr oder weniger gut.
Einordnung im Verzeichnis: LM Studio und Ollama lösen dieselbe Aufgabe für unterschiedliche Menschen. Ollama ist schlanker, skriptbarer und die bessere Grundlage für Server und Automatisierung. LM Studio ist das Werkzeug zum Ausprobieren, Vergleichen und täglichen Arbeiten — und inzwischen durch Agent und Transkription deutlich mehr als ein Modell-Betrachter. Wer offene Modelle zum ersten Mal auf dem eigenen Rechner sehen will, fängt hier an.
Screenshot
Pro & Contra
- Im Grundbetrieb vollständig lokal: Modelle, Chats und Sprachtranskription verlassen den Rechner nicht
- Grafische Oberfläche statt Kommandozeile — der niedrigschwelligste Einstieg in offene Modelle
- Zwei Laufzeitumgebungen unter der Haube: llama.cpp für breite Hardware, MLX für Apple Silicon
- Eingebauter lokaler API-Server, der sich als Ersatz für kommerzielle Schnittstellen einbinden lässt
- Cloud-Nutzung ist ausdrücklich optional und läuft nach Anbieterangabe ohne Datenspeicherung
- Brauchbare Geschwindigkeit setzt ordentliche Hardware voraus — viel Arbeitsspeicher, idealerweise eine GPU oder Apple Silicon
- Lokale Modelle bleiben in der Qualität hinter den großen kommerziellen Modellen zurück
- Das Programm selbst ist nicht quelloffen, anders als die Modelle, die es ausführt
- Die Cloud-Stufen laufen auf US-Servern — wer sie nutzt, verlässt den rein lokalen Betrieb
- Oberfläche auf Englisch, keine deutsche Fassung
Anwendungsfälle
Verwandte Tools
Kimi
Moonshot AIs Chatbot und offene Modellfamilie aus China — die Kimi-K2-Reihe glänzt bei Coding und agentischen Aufgaben und ist als Open-Weight-Modell frei verfügbar.
Poe
Quoras Chat-Aggregator — ein Abo, Zugriff auf ChatGPT, Claude, Gemini, Grok und dutzende weitere Modelle plus eigene Bots, in einer App über alle Plattformen.
Ollama
Der einfachste Weg, offene Sprachmodelle lokal zu betreiben — Llama, Mistral, Qwen, DeepSeek, GPT-OSS und mehr mit einem Befehl, vollständig on-device und DSGVO-freundlich.